Distribution Matching VAE (DMVAE):探索视觉生成的最佳 Latent Space
Tokenizer 的“两难困境”
主流的生成模型均采用“先压缩-再生成”的范式。一个理想的 Latent Space 需要同时满足两个互相矛盾的标准:
- 易于建模: Latent 分布 \(q(z)\) 应该足够简单,方便后续的 Diffusion 或 Autoregressive 模型对这个分布建模。
- 重建保真: Latent Code \(z\) 必须保留足够的信息以完美重建原图。
现有的方法往往无法达到很好的权衡:
- Standard VAEs: 使用 KL 散度将单样本后验分布拉向标准高斯 \(\mathcal{N}(0, I)\)。一般为了保证重建质量会采用较小 KL weight,这使得隐空间的流形建模难度高。
- RAE: 如果直接采用 DINO 这样的模型固定住当 encoder,虽然易于建模,但是不能重建原图,无法做后续的图像编辑等任务。
- VFM-based Methods (如 VAVAE, AlignTok): 使用点对点的损失函数(如 MSE)来拉近与预训练表征编码器的特征。然而 Point-wise 的对齐,并不能保证后验 \(q(z) = \int q(z\mid x)p(x)dx\) 形成一个易于建模的流形。
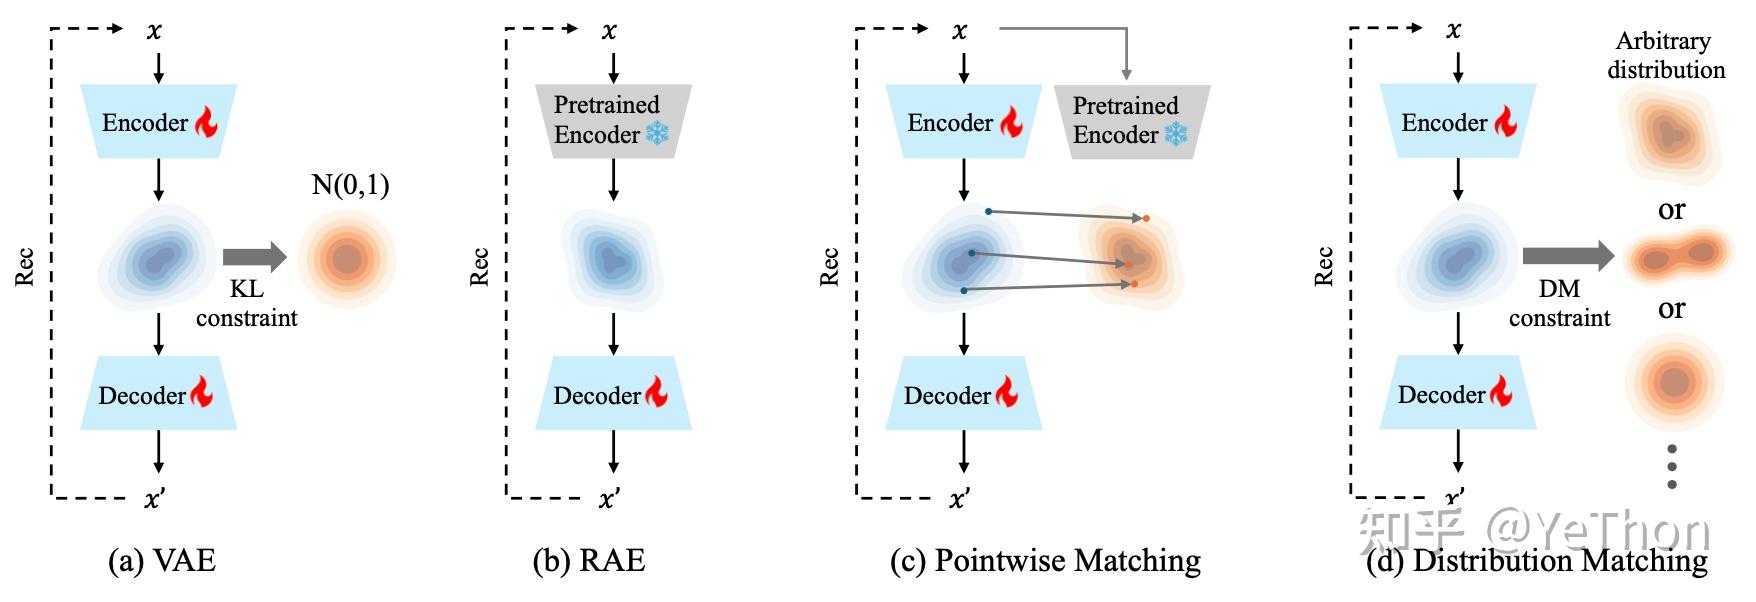
VAE、RAE、VFM-based methods 与 DMVAE 示意图
我们的方法:Distribution Matching VAE
我们提出了 DMVAE,核心思想是:直接在分布层面上约束 \(q(z)\),使其与任意参考分布 \(p_r(z)\) 对齐。 由于 \(q(z)\) 和 \(p_r(z)\) 都是高维、隐式的分布,直接计算 KL 散度不可行。受到 Distribution Matching Distillation (DMD) 的启发,我们用这两个分布的 score function 来表征这两个分布,通过这个“通用分布估计器”来解决度量分布距离的问题。
核心训练流程
我们的训练包含三个模型:
- Teacher (Real Score Model): 在参考分布 \(p_r(z)\)(例如 DINOv2 特征分布)上预训练一个 Diffusion Model,学习其 Score Function \(\nabla_z \log p_r(z)\),训练好后冻结。
- Student (Fake Score Model): 一个随 VAE 联合训练的 Diffusion Model,用于实时追踪 Encoder 输出分布 \(q(z)\) 的 Score Function。
- VAE Encoder: 同时进行重建与分布匹配目标的学习。
DMD Gradient 分布匹配的梯度:
\[\nabla_z \mathcal{L}_{DM} \propto s_{fake}(z) - s_{real}(z)\]DMD 的梯度会把 Latent Code 推向参考分布的高密度区域(由 \(s_{real}\) 引导),同时利用 \(s_{fake}\) 防止整体分布全部聚合到参考分布的 mode。相比于 GAN 或 Point-wise 的约束,该方法更稳定且能保留分布流形的全局结构。
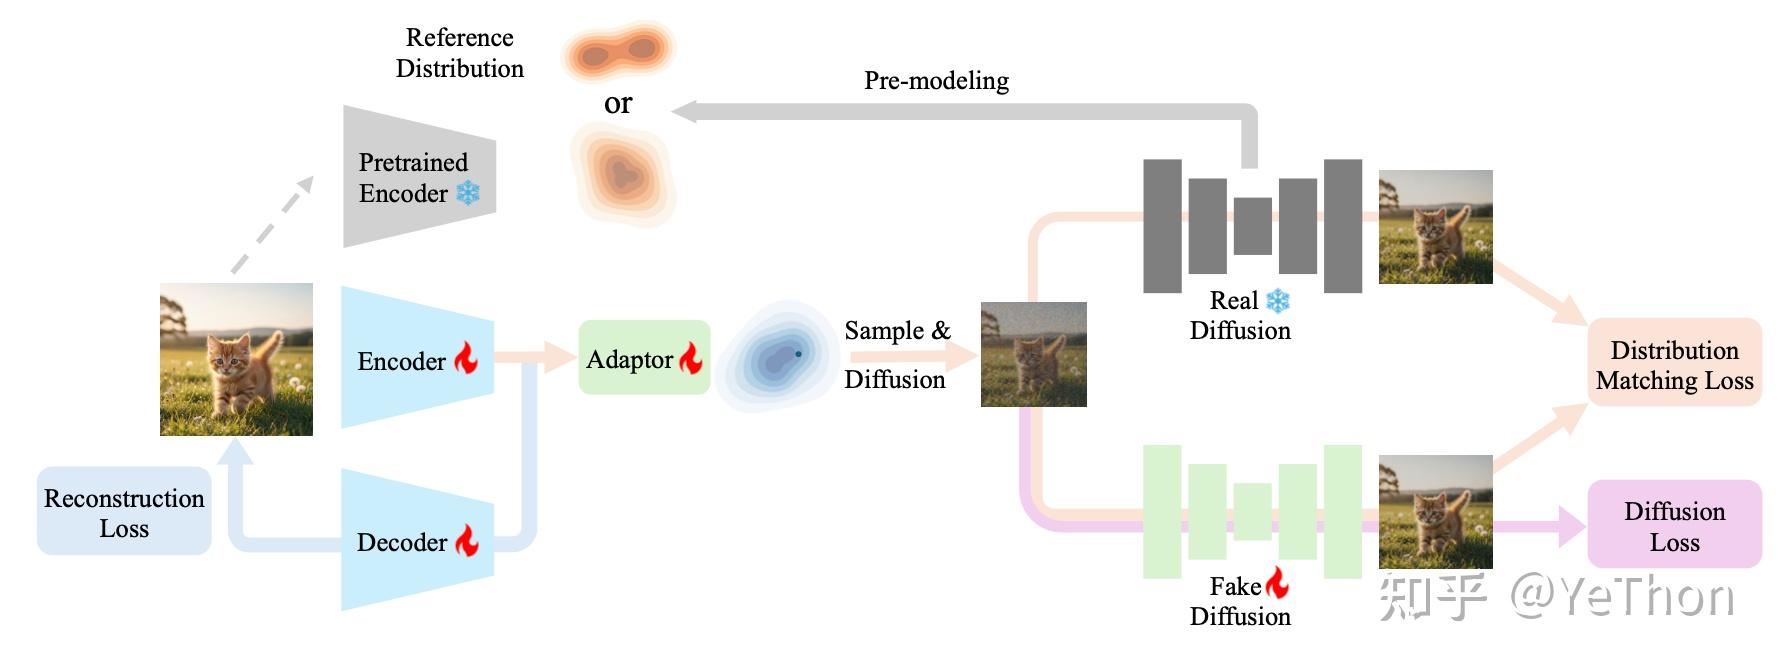
DMVAE 整体训练流程
分布匹配优化目标的选择
在分布匹配 loss function 的选择上,我们实际上可以有以下几种选择:
1. 最大化 real score function
FlowPrior 采用了这种思想,其期望最大化编码器的输出在 teacher model 下的似然。实现上,我们采用 v-prediction,loss 中可以在不同的位置加入 stop-gradient 算子,我们比较了三种不同的变体如下所示:
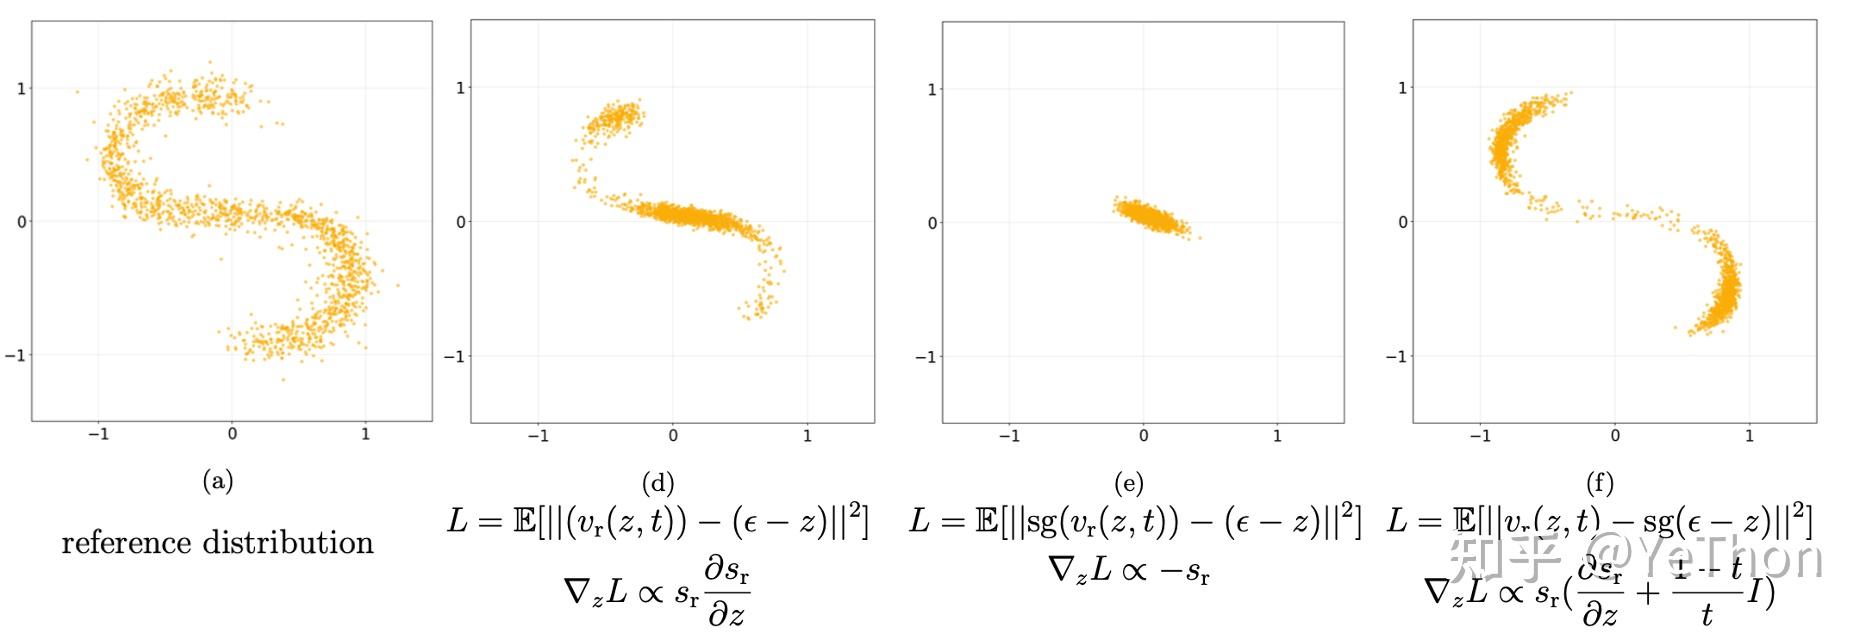
分布匹配目标之:最大化 real score function
可以看到,最大似然的做法会让样本点走向高概率的地方,产生了 mode dropping 的问题,无法很好地保留参考分布的全局结构。
2. 最大化 fake score function
这种方法将 VAE 与 Diffusion 同时进行训练,类似于 REPA-E 中提到的失败的 E2E 的训练版本。这种方法同样也有三种变体,如下图所示,该方法的训练会产生严重的 mode collapse,latent space 塌缩到一个或者几个点附近。
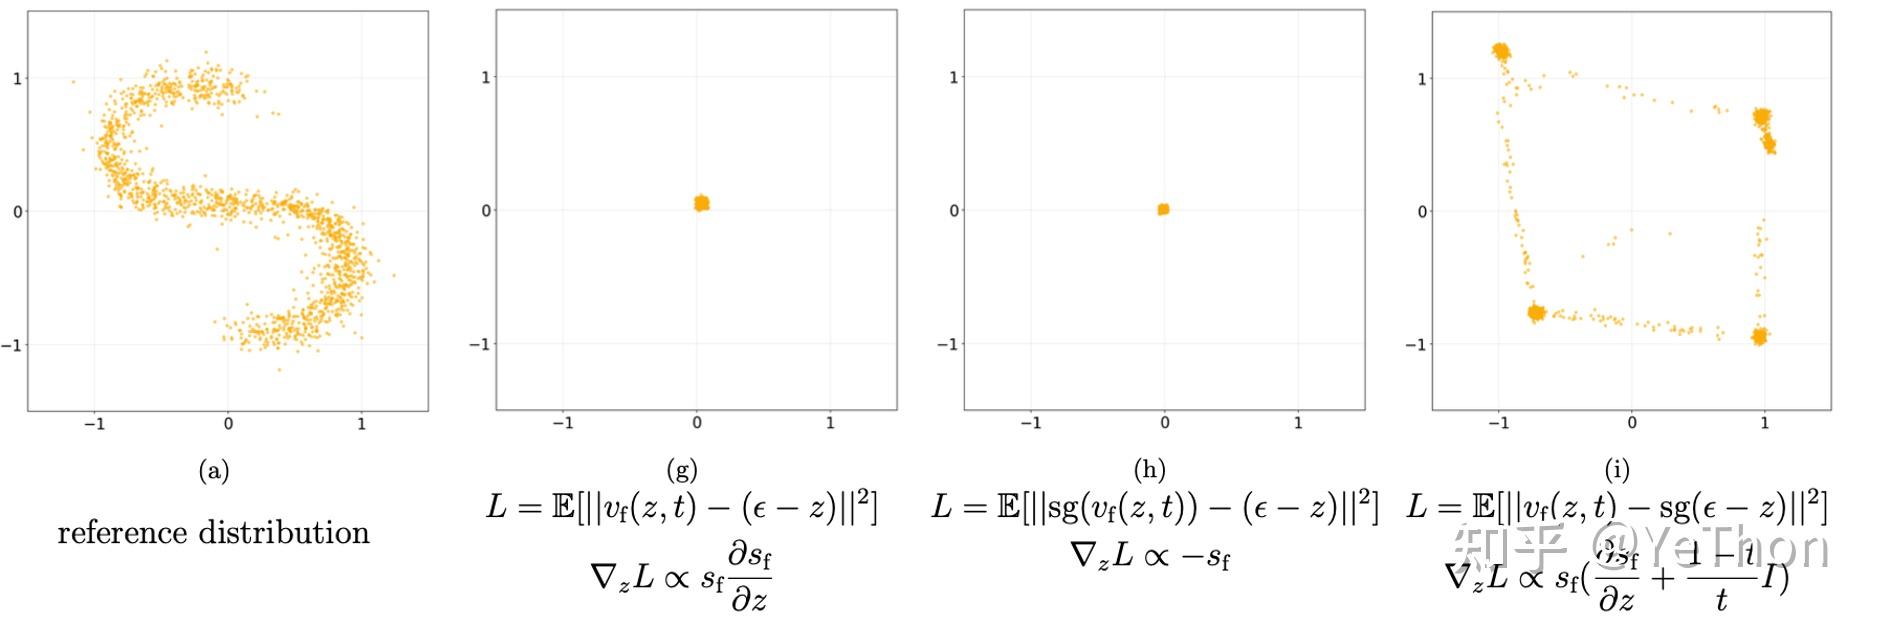
分布匹配目标之:最大化 fake score function
3. 最小化 student 和 teacher score function 之间的 L2 distance
同样在实现上有三种变体,如图所示,该方法也无法成功地进行分布匹配。
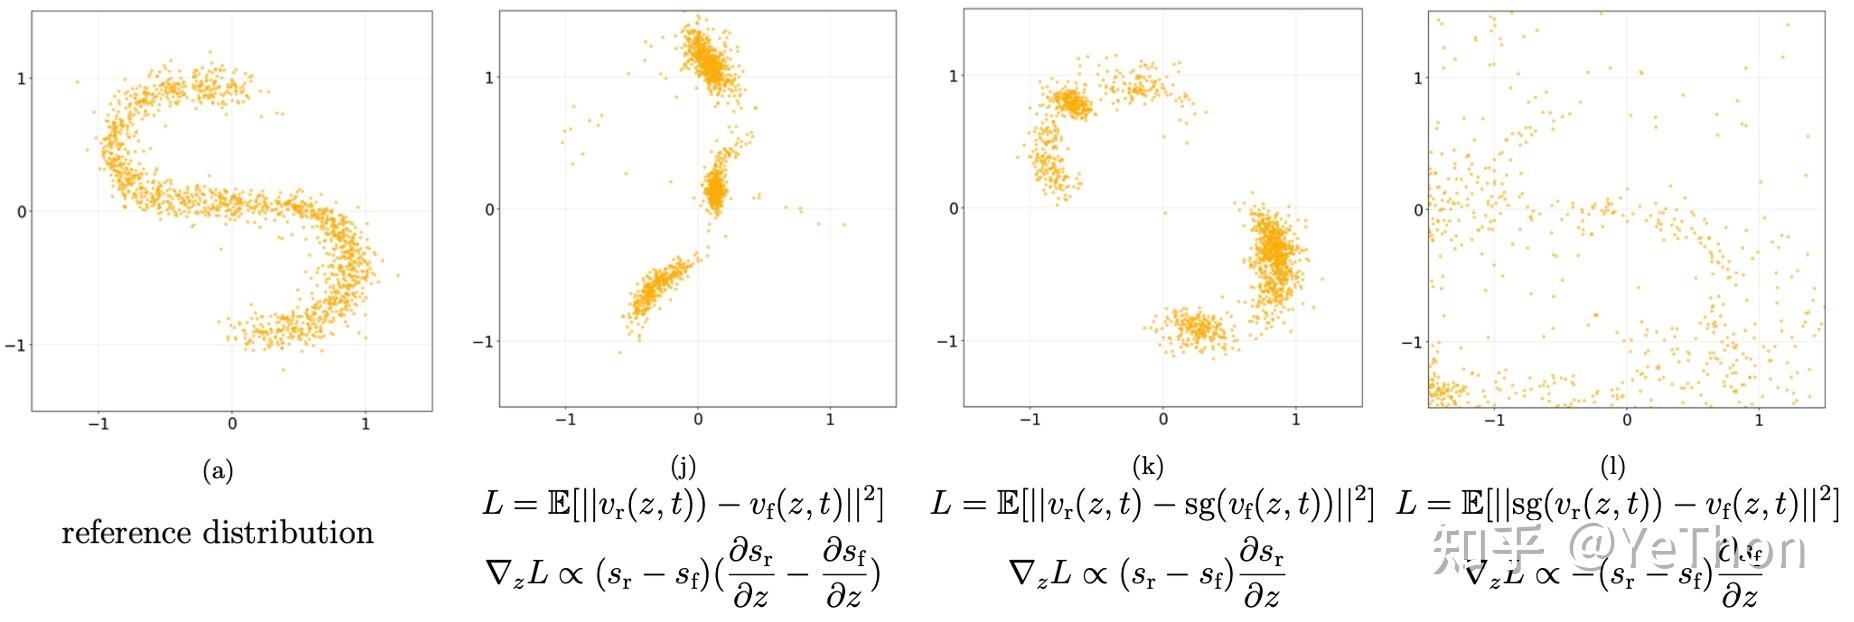
分布匹配目标之:最小化 student 和 teacher score function 之间的 L2 distance
4. 最小化 teacher 和 student flow matching loss 之间的差异
如下图(右)所示,该方法可以有效地进行分布匹配,然而,loss 的计算过程中需要计算两个 score model 的雅可比矩阵,针对高维图像的生成,这个计算较为昂贵。
5. 本文使用的方法
如下图(中)所示,本文使用的方法成功地将初始分布匹配到了目标分布,同时我们的方法不需要进行雅可比矩阵的计算,克服了上面四种方法遇到的 mode dropping 和计算效率低等问题。
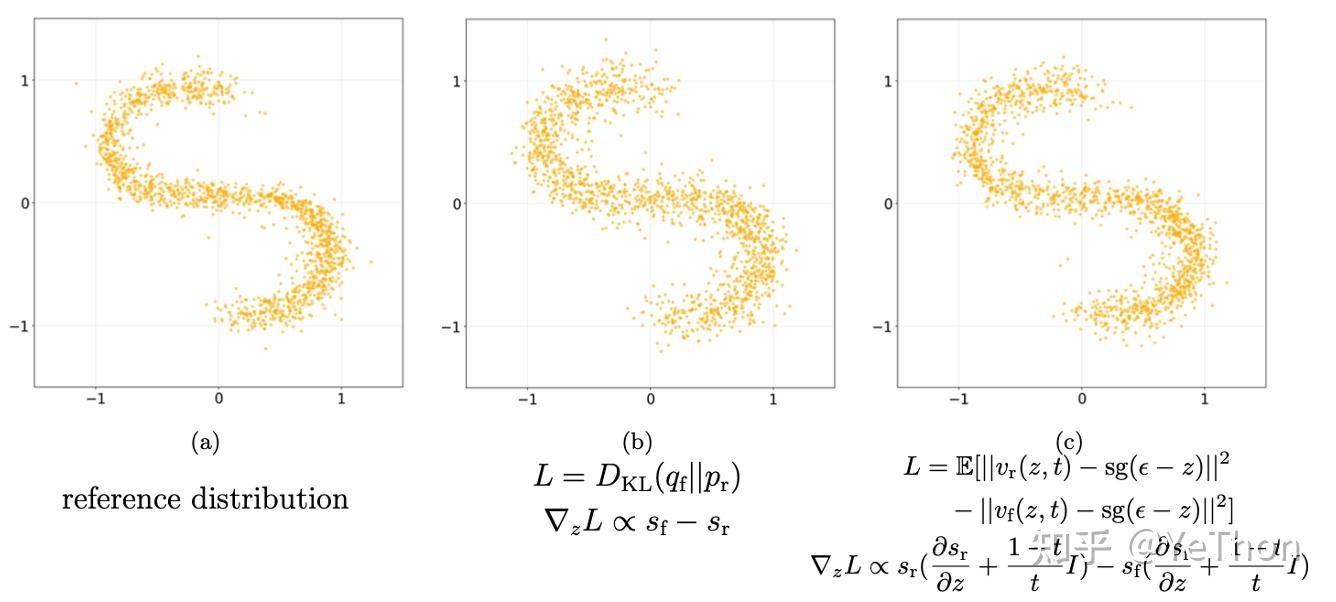
分布匹配目标之:DMD 与最小化 teacher 和 student flow matching loss
什么样的分布最适合生成?
DMVAE 将 Tokenizer 的设计问题转化为了 “参考分布选择” 的问题。因此,我们可以系统性地研究各种不同的分布的性质,比较哪种分布能达到重建与建模的完美平衡。
我们对比了两大类分布:
- Data-Derived: SSL 特征 (DINOv2)、Supervised 特征 (ResNet)、文本特征 (SigLIP-text)、Diffusion 中间步噪声。
- Data-Independent: 标准高斯、GMM、随机采样特征。
实验结论:Self-Supervised Learning (SSL) 的特征分布(如 DINO)是最佳选择。
通过 t-SNE 可视化我们发现:
- 高斯分布过于均一,缺乏语义结构,后续生成模型需要花费大量算力去重建语义聚类。
- DINO 分布天然具有极强的语义聚类(Semantic Clustering)特性。类内方差适中,类间界限清晰。
- DMVAE 成功地将这种优良的流形结构“蒸馏”到了 VAE 的 Latent Space 中,减少了生成模型的 confusion,降低了建模难度。
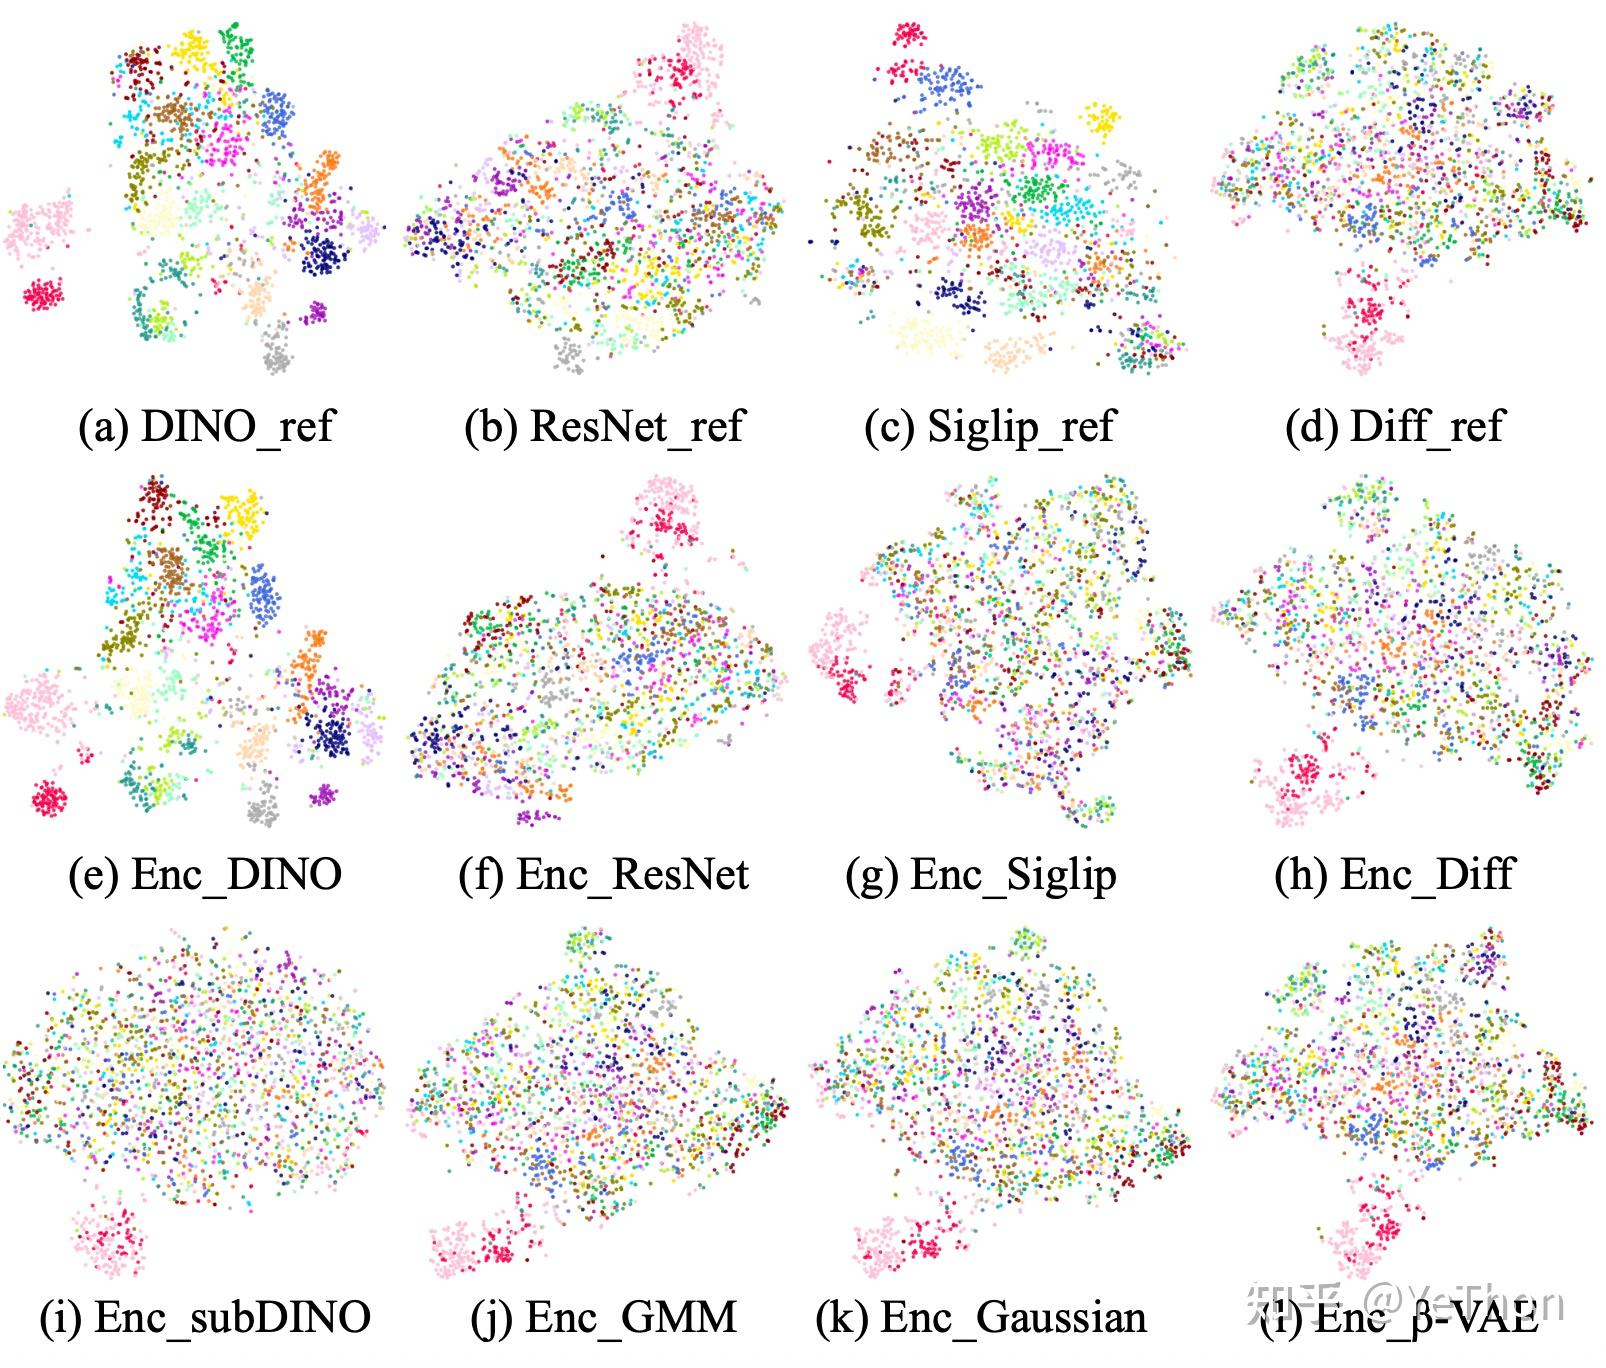
不同分布 t-SNE 可视化
我们发现在 DMD 的目标中使用一个较小的 CFG 值可以有效地提高生成的效果,我们使用了 t-SNE 可视化了不同 CFG 下的分布,我们发现使用 CFG 加强了对分布的语义聚类。
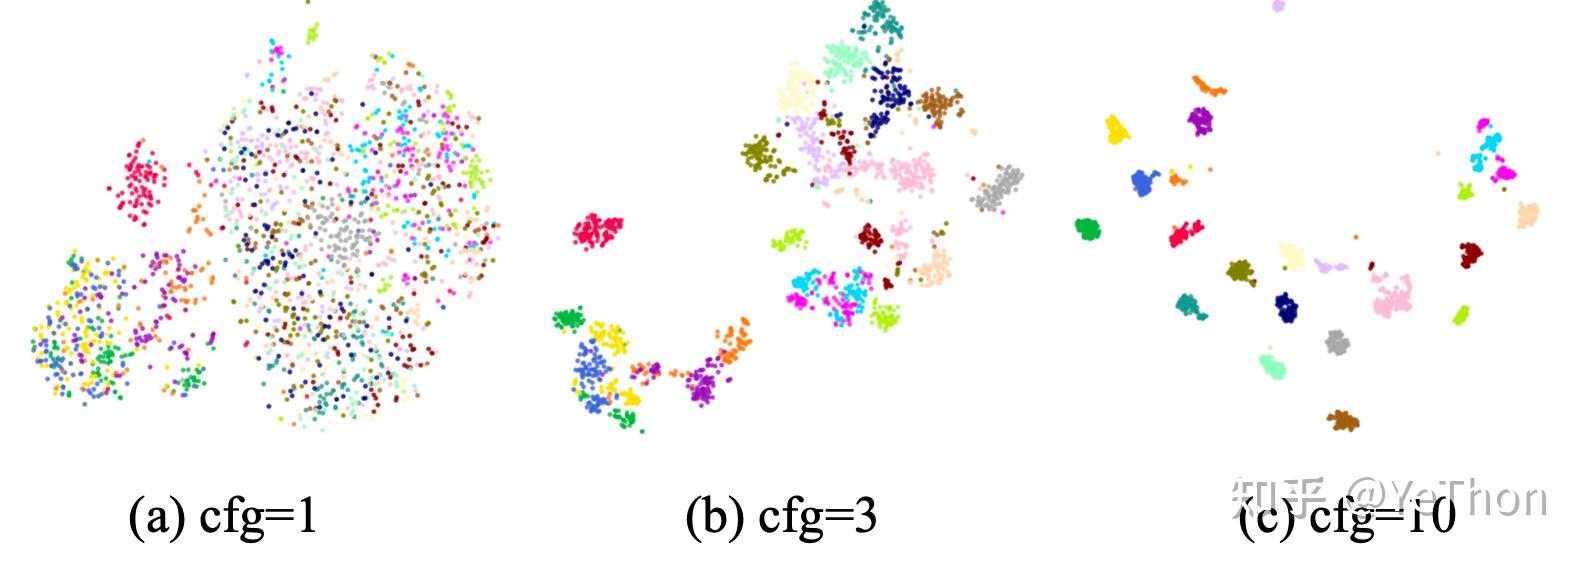
不同 CFG 下的分布
实验结果
我们在 ImageNet \(256 \times 256\) 上进行了验证,为了排除其他因素的影响,我们在测试时候没使用 CFG。
- 生成质量 (Generation): 在仅训练 64 epochs 的情况下,DMVAE 达到了 3.22 gFID。训练至 400 epochs 时,gFID 进一步降至 1.82。
- 收敛速度 (Convergence): 相比于 AlignTok 和 VAVAE 等方法,DMVAE 展现了更快的收敛速度与结果。
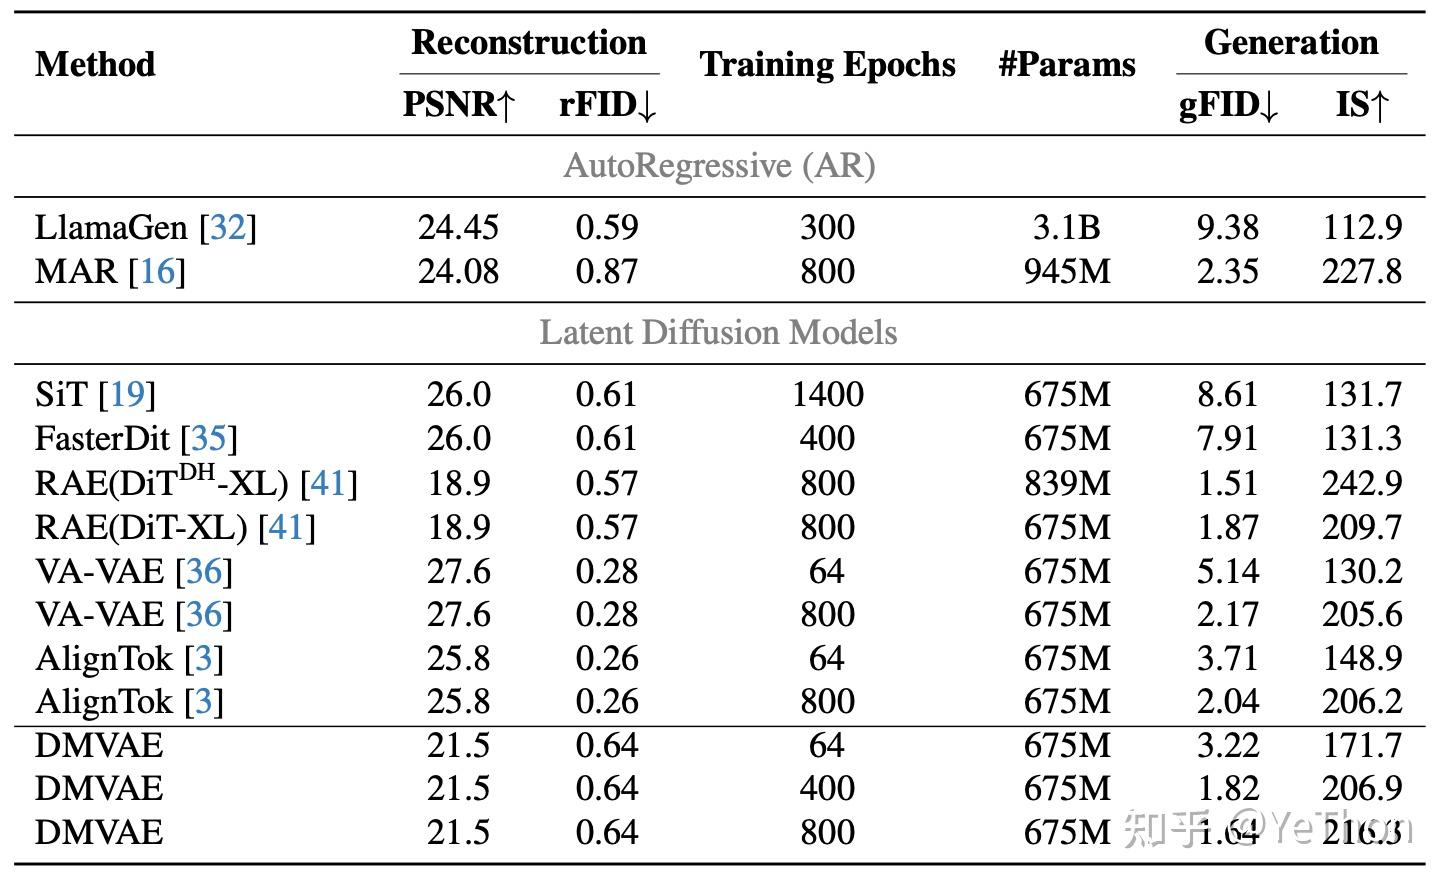
ImageNet256 上的重建与生成(无 guidance)结果
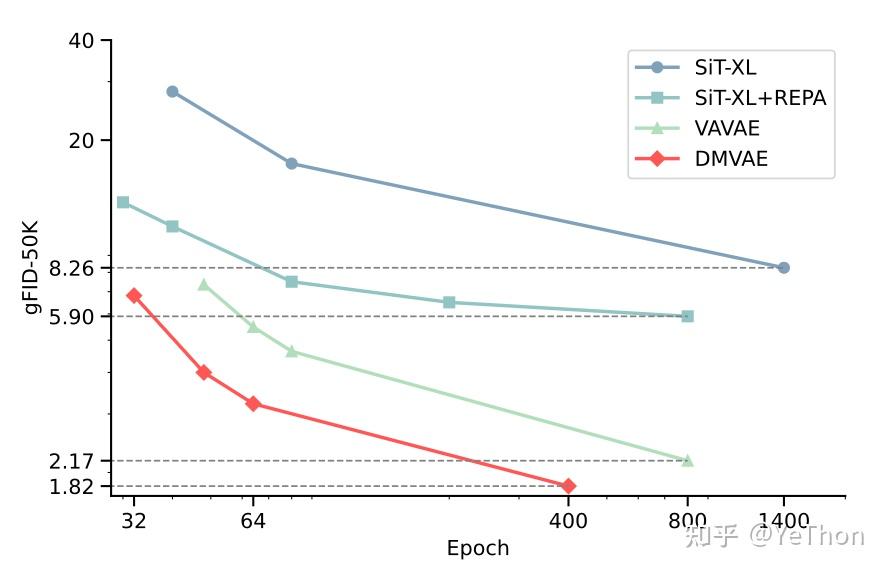
DMVAE 收敛速度与 baseline 的对比
总结
DMVAE 打破了 VAE 必须使用高斯先验的范式。通过 Distribution Matching,我们可以让 Latent space 的分布与任意参考分布对齐。
我们的研究表明,将 VAE 潜空间分布与视觉表征编码器的分布从分布层面对齐,是通向高保真、高效率视觉生成的捷径。